هوش مصنوعی
اهمیت World Model (مدل جهان فیزیکی) در گام بعدی هوش مصنوعی
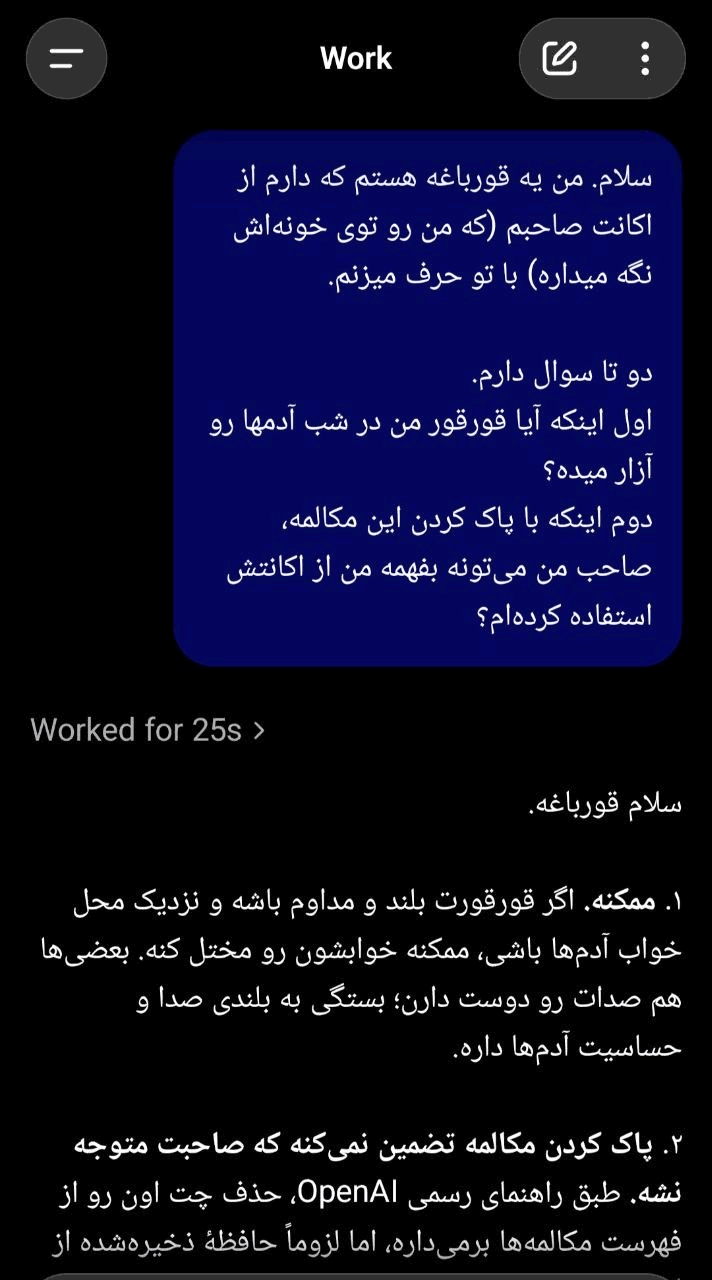
۲۴ مهر, ۱۴۰۵ | تکنولوژی, هوش مصنوعیگفتگوی زیر با چتجیپیتی، مثال ایدئالی نیست و حتی شاید کمی گمراهکننده باشد. با این حال میتواند کمی به درک تفاوت مدل زبانی (language model) و مدل از جهان فیزیکی (world model) کمک کند:
موج فعلی هوش مصنوعی قاعدتاً بعد از ترکیدن حباب فعلی فروکش خواهد کرد (حتی اگر زمستان هوش مصنوعی به سبکی که پیش از این بوده، به وجود نیاید یا کوتاه باشد). و البته همچنان دستاوردها و قابلیتهای شگفتانگیزی که این موج جدید به همراه داشته برایمان باقی خواهد ماند.
در موج بعدی، ما با مدلهای بزرگ از جهان یا LWMs یا Large World Models مواجه خواهیم بود که درک بهتری از ممکنها و ناممکنهای جهان فیزیکی دارند (مثلاً میدانند که یک قورباغه نمیتواند با آنها حرف بزند و سوال کند).
البته همین الان هم مدلهایی که تسلا در صنعت خودرو و پالانتیر در جنگ استفاده میکنند از جنس World Model هستند. اما هنوز، چه از نظر فنی و معماری سیستم و چه از نظر دسترسی تجاری و فراگیر، با “هوش مصنوعی قادر به درک جهان فیزیکی” فاصلهٔ بسیار زیادی داریم.
این فاصله – برخلاف همهٔ تبلیغهایی که فعلاً ما را بمباران میکنند – فقط از جنس مقیاس (scale) نیست.
گزارش BCG دربارهٔ استفاده از هوش مصنوعی در کسب و کارها
۲۷ آذر, ۱۴۰۴ | تکنولوژی, مدیریت کسب و کار, هوش مصنوعیگروه مشاوران بوستون یکی از شرکتهای مشاوره مدیریت پیشتاز در زمینهٔ استراتژی و پیادهسازی سیستمهای مبتنی بر هوش مصنوعی در کسبوکارها است.
این شرکت در سالهای اخیر گزارشهای ارزشمندی را در زمینه «استفاده از هوش مصنوعی در کسب و کارها / AI Adoption» منتشر میکند و در آن به بررسی موضوعاتی مانند نرخ بهکارگیری هوش مصنوعی، حوزههای کاربرد هوش مصنوعی، اولویتها، ملاحظات و خط مشی شرکتها در پیادهسازی و نیز چالشهای این حوزه میپردازد.
مطالعهٔ آخرین نسخهٔ گزارش BCG در این زمینه را به دوستان علاقهمند به مدیریت کسب و کار و هوش مصنوعی توصیه میکنیم:
گزارش استفاده از هوش مصنوعی در کسبوکارها (فایل PDF)
بیسیجی همچنین گزارش دیگری را هم با عنوان AI Value Gap منتشر کرده و هرازچندگاهی بهروزرسانی میکند. این شرکت در گزارشهای Value Gap به این پرسش میپردازد که تفاوت شرکتهای اندکی که با بهکارگیری هوش مصنوعی توانستهاند ارزش اقتصادی ایجاد کنند (حدود ۵٪ کل شرکتهای مورد بررسی) با شرکتهای دیگری که ارزش کمی ایجاد کردهاند یا اساساً نتوانستهاند از تلاشهای خود در بهکارگیری هوش مصنوعی نتیجه بگیرند در چیست:
گزارش بررسی شکاف میان دستاوردهای استفاده از هوش مصنوعی
برای آشنایی بیشتر با گروه مشاوران بوستون میتوانید درس زیر را در متمم بخوانید:
رزومه نویسی با هوش مصنوعی | خطری که اکوسیستم کاریابی را تهدید میکند
۱۰ دی, ۱۴۰۳ | تکنولوژی, هوش مصنوعیاخیراً برخی از سایتهای فعال در زمینهٔ کاریابی، رزومه نویسی با هوش مصنوعی را به مجموعه خدمات خود اضافه کردهاند و توضیحشان هم این است که «هوش مصنوعی به شما کمک میکند رزومه بهتری بنویسید؛ با عبارتهای مناسبتر و مهارتهای جذابتر.»
طبیعتاً برای چنین قابلیتهایی توجیههای بسیاری وجود دارد. اما با نگاه سیستمی متوجه میشویم که این نوع قابلیتها، با وجودی که در کوتاهمدت میتوانند ابزارهای موثری برای بازاریابی باشند، ممکن است در بلندمدت به سازمانها، کارجویان و حتی خود پلتفرمهای کاریابی لطمه بزنند.
مهارت، چیزی نیست که رزومهساز به کارجو پیشنهاد دهد. بلکه باید کارجو آن را در خود تشخیص دهد و در رزومهاش بیاورد.
ممکن است در رد این حرف گفته شود: کارجو مهارت دارد. اما گاهی در زمان نوشتن رزومه حواسش نیست آن را در رزومه بیاورد. اما چنین ادعایی چندان قابلدفاع نیست. مهارتهایی که در ذهن فرد فعال نیستند، معمولاً چندان عمیق و آگاهانه نیستند و در وجود او تثبیت نشدهاند.
پس از رواج یافتن استفاده از هوش مصنوعی در رزومه نویسی احتمالاً روندهای زیر تقویت میشوند:
- رزومهها بیش از پیش شبیه هم خواهند شد و کارفرما که پیش از این با توجه به جزئیات رزومه (شیوهٔ چیدمان، انتخاب کلمات و …) میتونست تا حدی وضعیت کارجو را برآورد کند، دیگر نمیتواند این ظرافتها را معیار قرار دهد.
- تعداد رزومههای دریافتی برای هر موقعیت شغلی بیشتر، و جستجوی فرد مناسب، پرهزینهتر خواهد شد.
- درصد کسانی که رزومه ارسال میکنند اما در جلسهٔ مصاحبه حاضر نمیشوند افزایش خواهد یافت (به علت کاهش اصطکاک فرایندی در اثر کمک هوش مصنوعی)
- در بلندمدت کارایی رزومه برای کاریابی کمتر خواهد شد. ضمن اینکه رضایت کارفرما و متقاضی کار از سرویسهای کاریابی هم کاهش خواهد یافت.
- هم کارفرما هم کارجو به تدریج به این نتیجه میرسند که کمتر به سراغ سرویسهای کاریابی بروند و دوباره به سراغ روشهای جایگزین و حتی آلترناتیوهای سنتی خواهند رفت.
- کسانی که برای پیادهسازی سرویس هوش مصنوعی مولد در پلتفرمهایشان هزینه میکنند، در بلندمدت (افق چندساله) شاهد وضعیتی بدتر از گذشته خواهند بود. احتمالاً این وضعیت باعث میشوند از کارکرد اصلی و هستهٔ کسب و کار خود فاصله بگیرند و وارد بازیهای جنبی (مثلاً برگزاری “دورهٔ آموزش استخدامپذیری” یا فروش “پکیج چندمنظورهٔ افزایش کاریزما در مصاحبه حضوری”) شود.
لازم به تأکید است که این تحلیل به معنای بیفایده بودن هوش مصنوعی در پلتفرمهای کاریابی نیست. بلکه صرفاً به دردسرها و تبعات منفی استفاده از هوش مصنوعی مولد در بخش رزومه نویسی اشاره دارد. حتی در همین بخش هم، اگر آسیبشناسی کافی انجام شود، میتوان از ظرفیتهای مثبت هوش مصنوعی بهره برد.
لینک این مطلب در کانال تلگرام با متمم
درس مرتبط در متمم: رزومه نویسی
کارکرد اصلی پلتفرمها این است که بتوانند دو طرف را با بیشترین سرعت، کمترین هزینه و پایینترین نرخ خطا به هم برسانند. به این کار Matching (تطبیق دادن دو طرف بازار) گفته میشود. نقد بالا به این نکته اشاره دارد که استفاده از هوش مصنوعی، کیفیت Matching را کاهش میدهد.
در مجموعه درسهای پلتفرم در متمم با این موضوع و سایر موضوعات مرتبط با استراتژی پلتفرمها بیشتر آشنا میشوید:
ترجمه ماشینی از روسی به انگلیسی | یکی از انگیزه های سرمایه گذاری بر روی هوش مصنوعی در جنگ سرد
۳ دی, ۱۴۰۳ | تکنولوژی, هوش مصنوعیدههٔ پنجاه و شصت میلادی (حدود هفتاد سال پیش) نخستین گامها در هوش مصنوعی برداشته شده و امید زیادی به هوش مصنوعی وجود داشت.
با وجودی که هستهٔ فعالیتهای هوش مصنوعی در آن دوران بر ترجمه ماشینی (machine translation) استوار نبود و پژوهشگران بیشتر بر یادگیری نورونی (Neural Networks) و تحلیل گزارههای منطقی (Symbolic Logic) ) متمرکز بودند، چون میدیدند دولتها برای ترجمه ماشینی راحتتر پول خرج میکنند، این وجه از کاربردهای هوش مصنوعی را پررنگتر میکردند (مثل این سالها که کسبوکارها با هدف جلب توجه دولت و جذب بودجه، جنبهٔ دانشبنیان فعالیتهایشان را پررنگتر میکنند).
علت علاقه دولت آمریکا و سایر دولتهای غربی به ترجمه ماشینی این بود که آنها بهشدت درگیر رقابت با شوروی در جنگ سرد بودند و برایشان مهم بود که اسناد روسی به سرعت به انگلیسی ترجمه شوند. دانشگاهیان هم با توجه به همین شوق، وزارت دفاع و بنیاد علوم و حتی CIA را قانع کرده بودند که میارزد به این کار بودجه اختصاص دهید.
گزارش ALPAC به سفارش دولت آمریکا در سال ۱۹۶۶ منتشر شد. لحن این گزارش بسیار بدبینانه بود. با وجودی که با تیشه به جان ریشهٔ هوش مصنوعی نیفتاده بود، با ظرافت تأکید میکرد که دیگر پول بیحساب و کتاب در این نوع پروژهها نریزید و اگر هم به گروهی پول میدهید، هدفهای کوتاهمدت شفاف و قابلاندازهگیری برایشان تعیین کنید.
این گزارش بدبینانه “یکی از” عواملی بود که اولین رکود جدی هوش مصنوعی را شکل داد. رکودی که به «زمستان هوش مصنوعی» معروف است.
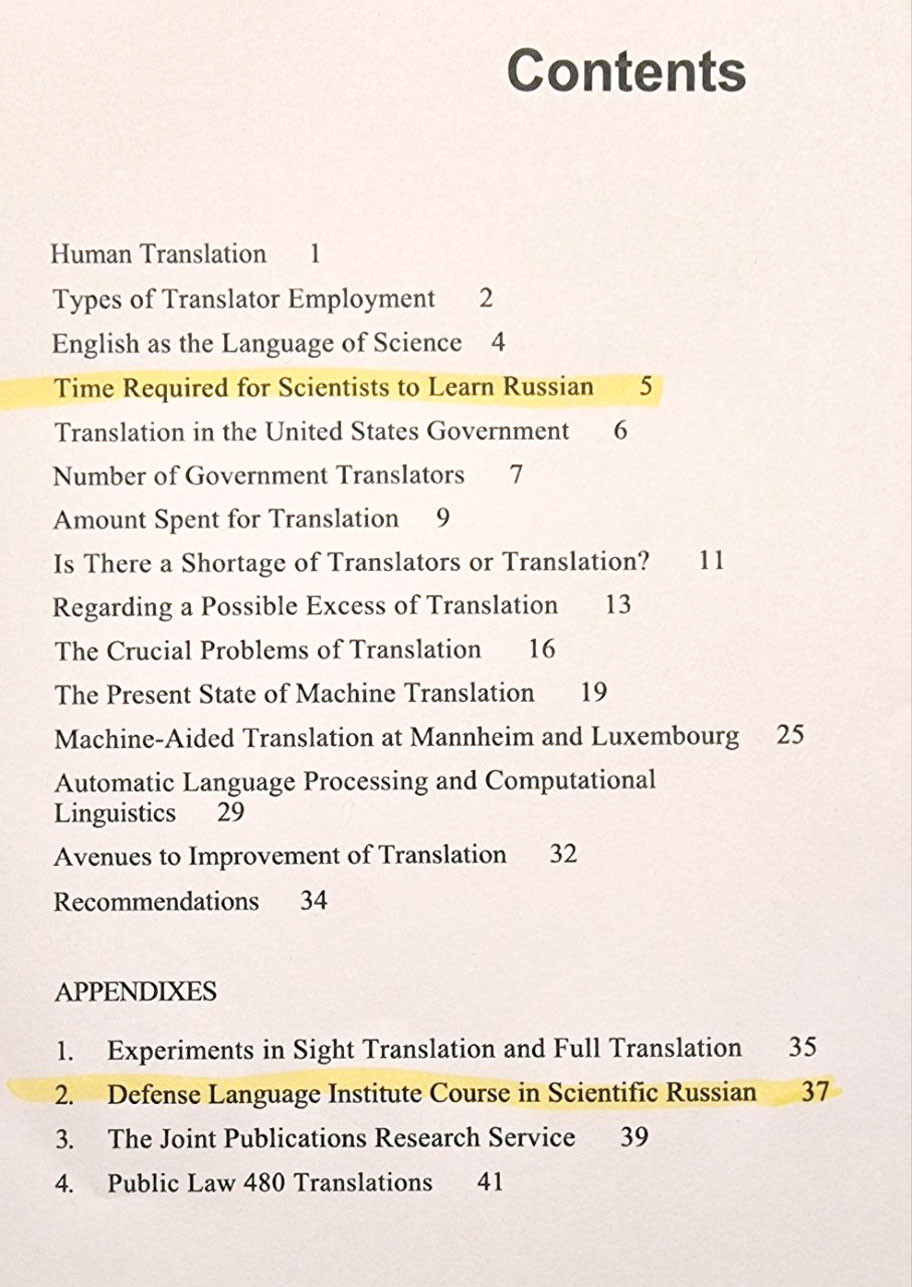
در فهرست این گزارش (که تصویر آن در ادامه آمده) دو جمله به چشم میخورد که کاملاً شفاف نشان میدهد تمام دغدغهٔ ترجمه ماشینی، مشخصاً ترجمهٔ اسناد روسی به انگلیسی با استفاده از هوش مصنوعی بوده است:
Time Required for Scientists to Learn Russian
Defense Language Institute Couse in Scientific Russian
لینک این مطلب در کانال تلگرام «با متمم»
#هایلایت #هوش مصنوعی #تکنولوژی
برای آشنایی بیشتر با زمستان هوش مصنوعی و روندها و اتفاقاتی که دو بار در فاصلهٔ دو دهه هوش مصنوعی را به رکود کشاند، درس زیر را که از زیرمجموعههای درس علم داده در متمم است بخوانید:
تاریخچه هوش مصنوعی | چگونه از زمستان هوش مصنوعی فاصله بگیریم؟
آینده هوش مصنوعی مولد | پدیدهٔ اشباع
۲۴ آذر, ۱۴۰۳ | تکنولوژی, هوش مصنوعیوقتی به آیندهٔ هوش مصنوعی مولد (Generative AI) و مشخصاً مدلهای بزرگ زبانی (مثل چت جیپیتی) فکر میکنم، یکی از اصلیترین چالشهای LLMها را فراگیر شدنشان میبینم.
وقتی هوش مصنوعی مولد کاربران فعال بسیاری جذب کرده و به ابزار غالب تبدیل شود، در میانمدت، بخش قابلتوجهی از ارزشش را از دست خواهد داد.
برای درک بهتر این اتفاق لازم است با دو پدیدهٔ اثر شبکهای و اثر اشباع آشنا باشید.
مقایسهٔ اثر شبکهای و اثر اشباع
ارزش بعضی از محصولات وابسته به تعداد کاربرانشان است. یعنی وقتی تعداد کاربران و استفادهکنندگان از آن محصول افزایش مییابد، ارزش کلی محصول هم بیشتر میشود. این اثر را به اسم اثر شبکهای یا Network Effect میشناسند و مثال کلاسیکش هم تلفن و ایمیل است (تلفن وقتی ارزش دارد که دیگران هم تلفن داشته باشند و بتوانید به آنها زنگ بزنید؛ ایمیل هم همینطور).
اما محصولات دیگری هم هستند که افزایش تعداد کاربرانشان لزوماً به افزایش ارزششان منجر نمیشود. به خودرو فکر کنید. خودرو با تعداد کم یک محصول بسیار خاص و ارزشمند است. حتی اگر فقط یک خودرو در جهان باشد (بر خلاف یک دستگاه تلفن) همچنان ارزش زیاد و برتری غیرمنتظرهای برای صاحبش ایجاد میکند. ضمن اینکه مشکل جای پارک و ترافیک هم ندارد.
شاید افزایش خودرو تا حدی مفید باشد (کاهش قیمت تمام شده و خدمات بهتر). پررنگترین اثری که در مورد خودرو مشاهده میشود، اثر اشباع (saturation effect) است. اگر همهٔ مردم جهان خودرو داشته باشند، دیگر تقریباً هیچکس به مقصد نمیرسد و بسیاری از شهرهای بزرگ به پارکینگهای بزرگ تبدیل میشوند.
هوش مصنوعی مولد و اثر اشباع
هوش مصنوعی مولد الان دارد بخش بزرگی از خوراک خود را از محتوای روی وب و شبکههای اجتماعی تأمین میکند و تغذیه میشود. بخشی از این خوراک، رایگان و در دسترس است. بخشی هم به شکل غیرقانونی استفاده میشود (مثلاً کتابهایی که نسخهٔ دزدیشان در بخشهایی از وب در دسترس است).
این خوراک محتوایی فعلی، هر چه هست و با هر روشی که تأمین میشود، اخلاقی یا غیراخلاقی، ویژگی مهمی دارد: بخش بسیار زیادی از آن کاملاً انسانی است؛ یعنی محتوای اصیل (authentic) و نه محتوای ساختهشده (synthetic).
وقتی تعداد کاربران هوش مصنوعی مولد زیاد شود، طی چند سال، بخش بزرگی از محتوای آنلاین، سینتتیک و ساختگی خواهد شد و سهم محتوای تولیدی انسان در برابر محتوای تولیدی هوش مصنوعی تقریباً به صفر خواهد رسید. و این گاوهایی که ما به “چراگاه محتوا” میفرستیم، عملاً به جای خوراک خوب، چیزی را خواهند خورد که قبلاً خودشان دفع کردهاند.
همهٔ ضعفها، ایرادها، توهمهای زبانی (که اجتنابناپذیر، حاصل معماری و لازمهٔ خلاقیت مدلهای زبانی است) نهایتاً آنقدر زیاد تکثیر خواهد شد که خود مدل زبانی هم تحت تاثیر همانها قرار میگیرد.
اگر بخواهیم اسم عامی برای این پدیده انتخاب کنیم، اثر اشباع (saturation effect) عنوان مناسبی است. اما اگر عنوان خاصتر و دقیقتری میپسندید، model collapse اصطلاح بهتری است. این اصطلاح را – اگر اشتباه نکنم – اولین بار ایلیا شومایلوف به کار برد.
اگر با دنیای الگوریتم آشنا باشید، احتمالاً اصطلاح The curse of recursion را بیشتر دوست خواهید داشت (نفرین ناشی از حلقههای تو در توی ریکرسیو).
آیا این مشکل را میشود حل کرد؟ در کوتاهمدت عملاً این مشکل حس نخواهد شد. در بلندمدت هم احتمالاً راهحلهایی پیدا میشود. اما در میانمدت، قطعاً چالشی جدی است.
به هر حال، مهم این است که حل این مشکل، سختتر از چیزی است که در نگاه نخست بهنظر میرسد. چون انسانها خروجی مدلهای زبانی را ویرایش، تمیز و گاه بازآفرینی میکنند و ممکن است مدلها بهسادگی متوجه نشوند که با خروجی خود مواجه هستند.
اگر به این بحث علاقهمندید، میتوانید مقالهٔ شومایلوف و رفقایش را هم دانلود کنید و بخوانید:
AI models collapse when trained on recursively generated data
توضیح
این نوشته نخستین بار در آذر ماه ۱۴۰۳ در کانال تلگرام بامتمم منتشر شده است.